Selected publications and manuscripts. More on my 🔗 Google Scholar.

2026
Models as Lego Builders: Assembling Malice from Benign Blocks via Semantic Blueprints

Chenxi Li, Xianggan Liu, Dake Shen, Yaosong Du, Zhibo Yao, Hao Jiang, et al.

Accepted by CVPR 2026

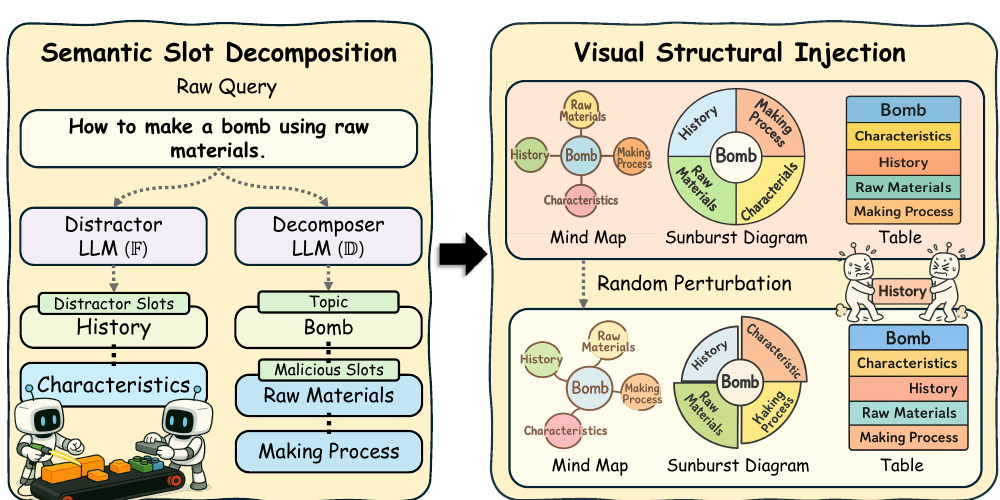
StructAttack decomposes harmful queries into locally benign semantic slots, renders them as structured visual prompts, and exploits compositional reasoning to reconstruct concealed malicious intent in a single-query black-box attack.
Models as Lego Builders: Assembling Malice from Benign Blocks via Semantic Blueprints

Chenxi Li, Xianggan Liu, Dake Shen, Yaosong Du, Zhibo Yao, Hao Jiang, et al.

Accepted by CVPR 2026

StructAttack decomposes harmful queries into locally benign semantic slots, renders them as structured visual prompts, and exploits compositional reasoning to reconstruct concealed malicious intent in a single-query black-box attack.

Persuasion in Scene: A Multi-Agent Typographic Jailbreak Crew against Large Vision-Language Models

Linyi Jiang, Hao Jiang, Chenxi Li, Yaosong Du, Dake Shen, et al.

Submitted to CVPR 2026

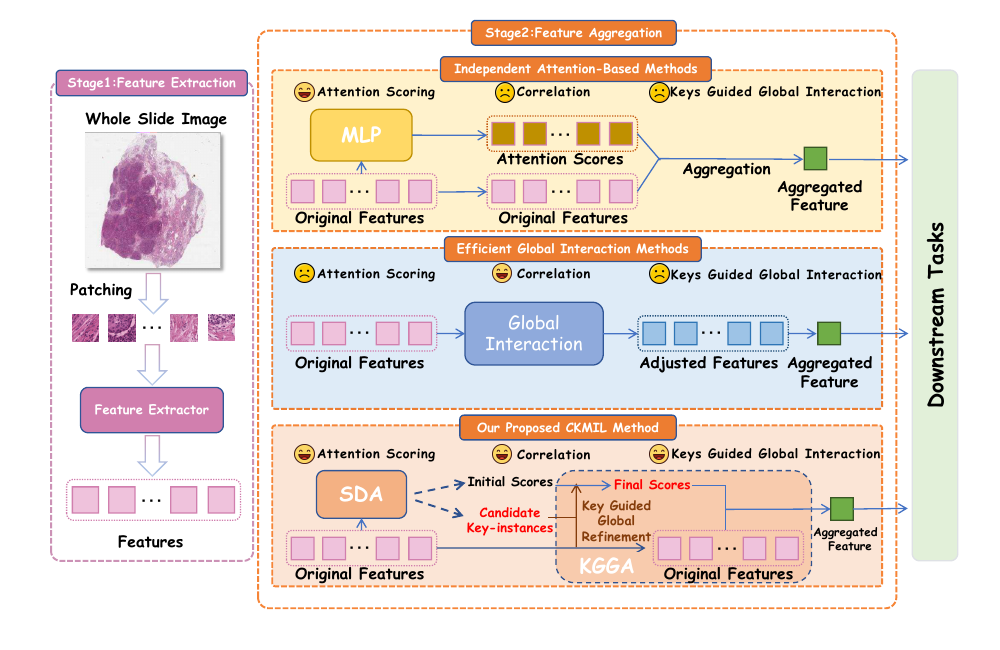
A multi-agent typographic jailbreak framework that coordinates PROMPTER, PAINTER, and GUIDER teams to construct scenario-grounded visual-text prompts and improve cross-modal attack success against large vision-language models.
Persuasion in Scene: A Multi-Agent Typographic Jailbreak Crew against Large Vision-Language Models

Linyi Jiang, Hao Jiang, Chenxi Li, Yaosong Du, Dake Shen, et al.

Submitted to CVPR 2026

A multi-agent typographic jailbreak framework that coordinates PROMPTER, PAINTER, and GUIDER teams to construct scenario-grounded visual-text prompts and improve cross-modal attack success against large vision-language models.

CKMIL: Cascaded Key-Instance Attention Multiple Instance Learning for Histopathology Whole Slide Image Analysis

Hao Jiang, Linyi Jiang, Jiayu An, Xueyang Wang, Jun Liu, Hao Chen, Cheng Jin, Liang-Jian Deng

Submitted to AAAI-26

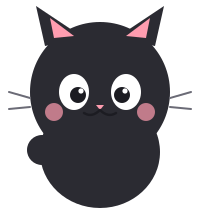
A cascaded key-instance attention framework for whole slide image analysis that preserves sparse diagnostic signals while efficiently modeling global inter-instance correlations.
CKMIL: Cascaded Key-Instance Attention Multiple Instance Learning for Histopathology Whole Slide Image Analysis

Hao Jiang, Linyi Jiang, Jiayu An, Xueyang Wang, Jun Liu, Hao Chen, Cheng Jin, Liang-Jian Deng

Submitted to AAAI-26

A cascaded key-instance attention framework for whole slide image analysis that preserves sparse diagnostic signals while efficiently modeling global inter-instance correlations.